

נקודות עיקריות
- •גוגל הכריזה על צמד מודלי המרת טקסט לדיבור חדשים במשפחת ג'מיני: Gemini 3.8 Flash TTS ו-Gemini 3.8 Flash-Lite TTS.
- •המודלים מאפשרים עיצוב קולות מותאמים אישית באמצעות פקודות טקסט ביותר מ-100 שפות וניבים, ובהן עברית.
- •שכפול קול נתמך מדגימת שמע של 30 שניות ומחייב אימות הסכמה מוקלט, לצד הטמעת חותמת מים מסוג SynthID.
- •המודלים זמינים למפתחים ב-Gemini API וב-Google AI Studio, לצד שילוב ב-Gemini Notebook וב-Google Vids.
גוגל (Google) הכריזה על שני מודלי המרת טקסט לדיבור (TTS) חדשים במשפחת Gemini, ה-Gemini 3.8 Flash TTS ו-Gemini 3.8 Flash-Lite TTS.
המודלים החדשים מרחיבים את יכולות האודיו של החברה ומיועדים להעניק למפתחים, יוצרי תוכן וארגונים כלים גמישים להפקת קולות מותאמים אישית, בימוי דיאלוגים מורכבים והפעלת סוכני קול בקנה מידה רחב.
לדברי גוגל, Gemini 3.8 Flash TTS מתמקד בבימוי יצירתי מעמיק ועיצוב דמויות, ומאפשר ליצור קולות חדשים לחלוטין באמצעות פקודות בשפה טבעית עבור משחקים, ספרי שמע ופודקאסטים.
לצידו, Gemini 3.8 Flash-Lite TTS תוכנן להפעלה בעומסים גבוהים ובעלות יעילה, ומתאים למשימות דיבוב המוניות, יצירת תוכן שמע וסוכני שירות קוליים.
מאפיינים עיקריים
המודלים החדשים מציעים סביבת עבודה המאפשרת יצירת קולות מותאמים אישית מאפס (Generative voice design). המשתמשים יכולים להגדיר תפקיד, מבטא ומאפייני קול ביותר מ-100 שפות וניבים, לצד גישה לספרייה של יותר מ-2,000 קולות מוכנים מראש.
עברית נכללת ברשימת השפות הנתמכות בשני המודלים, שמזהים את שפת הקלט באופן אוטומטי. Gemini 3.8 Flash TTS תומך ב-130 שפות, ו-Gemini 3.8 Flash-Lite TTS ב-101 שפות.
בנוסף, המערכת כוללת יכולת שכפול קול (Voice replication) מדגימת שמע של 30 שניות בלבד, תוך שמירה על פרופיל קולי עקבי לאורך פרויקטים מתמשכים.
בהמשך צפויה להתווסף אפשרות Voice remixing, שתאפשר לבחור קול מתוך הספרייה ולשנות מאפיינים כמו גוון, גובה צליל, קצב ומבטא באמצעות הנחיות טקסט.
על מנת להגן על יוצרים ולמנוע שימוש לרעה, גוגל שילבה מנגנון אימות הסכמה (consent verification), המחייב הקלטת אישור קולי מבעל הקול התואמת לדגימת השמע לפני תחילת השכפול.
כמו כן, כל קטע שמע המיוצר באמצעות המודלים מוטמע בחותמת מים דיגיטלית מסוג SynthID ופרטי זיהוי C2PA.
שליטה ובימוי ביצועים
שני המודלים מאפשר שליטה נקודתית בכל שורת טקסט, החל מהוראות בימוי ישירות ועד מתן אפשרות למודל לכוון את אופן ההגשה באופן עצמאי.
יכולת זו מאפשרת לעצב דיאלוגים מרובי משתתפים מתסריט יחיד (Native two-speaker scene staging), תוך שמירה על הפרדה ברורה בין הדוברים וניהול טבעי של תורות דיבור.
היוצרים יכולים להוסיף רמזים לא מילוליים, דוגמת צחוק, אנחה או התנשפות, וכן קריאות ביניים המעידות על הקשבה פעילה לתזמון קומי ותגובות מהירות.
ביצירת תוכן ארוך, המודלים שומרים על איכות הקול וגוון הדמות לאורך שעות של שמע רציף ללא סטייה קולית מהותית.
ביצועים ובדיקות השוואה
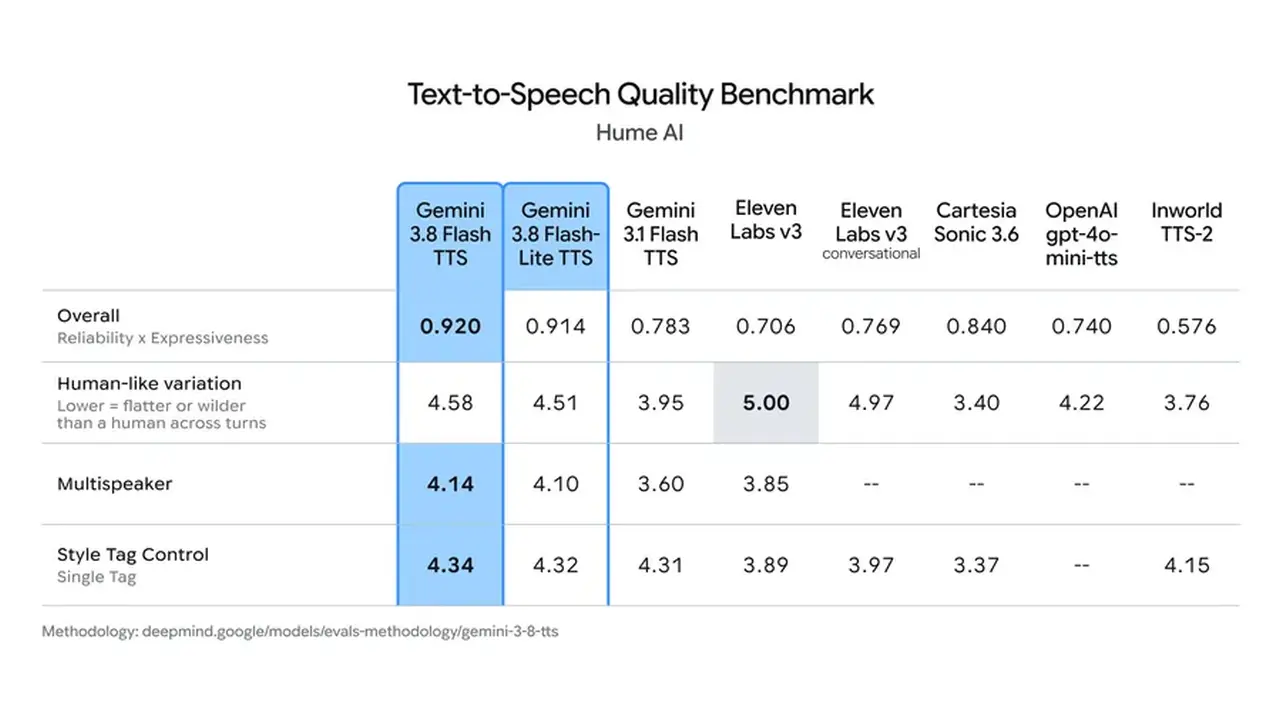
לפי נתוני גוגל, Gemini 3.8 Flash TTS זכה במקום הראשון במבחן Voice Design של Hume AI עם ציון 71.4, והוביל במידול מבטאים עם ציון 60.8. במדד האיכות הכולל (Overall Quality Index) של Hume AI, המודלים Gemini 3.8 Flash TTS ו-Gemini 3.8 Flash-Lite TTS תפסו את המקומות הראשון והשני בהתאמה.
החברה מציינת שיפורים בתוכן ארוך ובשליטה בתסריטים של שני דוברים בהשוואה למודל Gemini 3.1 Flash TTS.
בהערכות העדפה עיוורות ב-Voice Arena, המודלים השיגו דירוגים מובילים בשפות מרכזיות, ובהן ערבית סטנדרטית מודרנית (MSA), ספרדית מקסיקנית, פורטוגזית ברזילאית, ויאטנמית, הינדי ויפנית.
זמינות
המודלים החדשים Gemini 3.8 Flash TTS ו-Gemini 3.8 Flash-Lite TTS זמינים החל מהיום עבור מפתחים דרך Gemini API ובאמצעות סביבת עבודה ייעודית ב-Google AI Studio.
בנוסף, Gemini 3.8 Flash TTS זמין לקהל הרחב בשירות Gemini Notebook, בעוד Gemini 3.8 Flash-Lite TTS זמין למשתמשים ב-Google Vids.

