

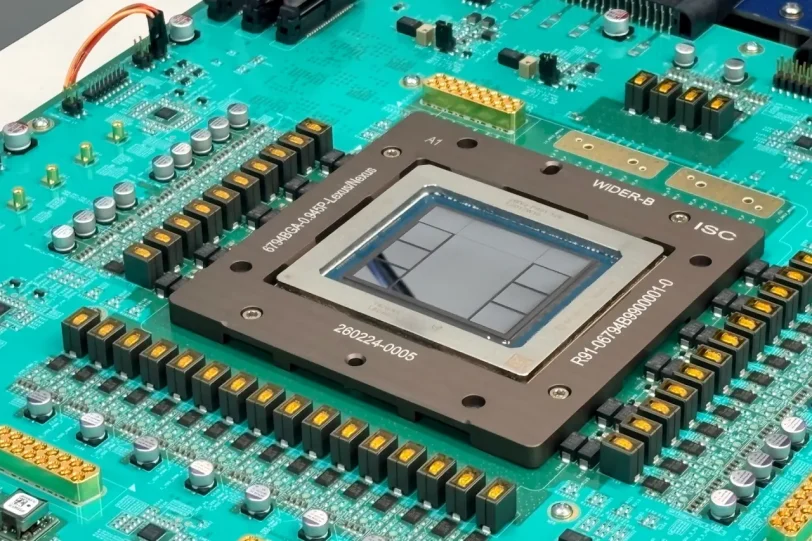
⭐ נקודות עיקריות
- חברת OpenAI חשפה נתוני ביצועים רשמיים למעבד ההסקה הראשון בפיתוח עצמי Jalapeño.
- לדברי החברה, המאיץ מספק ביצועים גבוהים פי 1.5 עד 1.9 לכל וואט לעומת מערכות מתחרות.
- בדיקות במבחן InferenceX מציגות זמני שיהוי נמוכים פי 1.7 עד 3.6.
- פריסת השבב במרכזי נתונים צפויה להתחיל לקראת סוף שנת 2026.
חברת OpenAI פרסמה נתוני ביצועים רשמיים ראשונים עבור Jalapeño ("חלפיניו"), מעבד ההסקה (Inference) הייעודי הראשון שפותח בחברה בשיתוף ברודקום (Broadcom).
לפי החברה, השבב מספק יעילות אנרגטית גבוהה עד פי 1.9 וזמני שיהוי נמוכים עד פי 3.6 לעומת מערכות מתחרות מובילות. המעבד מיועד להרצת מודלי שפה גדולים (LLMs) וסוכני AI אינטראקטיביים ביעילות גבוהה ובעלות תפעול נמוכה.
הנתונים שפורסמו מהווים את אחד הצעדים המעשיים הבולטים של OpenAI בבניית תשתית סיליקון עצמאית (Full-stack).
לפי החברה, שילוב הדוק בין שכבות התוכנה, התקשורת והחומרה מאפשר להפחית את התלות במאיצים חיצוניים ולספק מענה לדרישות המחשוב הגוברות של משתמשי השירותים שלה.
הכירו את ה-Jalapeño
שבב Jalapeño תוכנן מהיסוד עבור עומסי עבודה של הסקה בזמן אמת, תוך התמקדות בביצועים יציבים עבור סוכנים אוטונומיים הנדרשים לביצוע רצף של פעולות חישוביות.
פיתוח השבב הושלם בלוח זמנים של תשעה חודשים מתחילת התכנון ועד לייצור (Tape-out), בסיוע מודלי בינה מלאכותית של החברה.
ארכיטקטורת המערכת נבנתה במטרה לצמצם צווארי בקבוק בתנועת נתונים בין זיכרון, רשת ומעבדים. החברה מציינת כי המאיץ שומר על מצב המודל וזיכרון ה-KV Cache באופן מקומי, תוך התאמה אוטומטית לשלבי העיבוד השונים של מודלי שפה.
Since announcing Jalapeño, our first custom inference chip, we’ve been testing it and the system around it.
The results show a major advance: more intelligence from every watt and faster responses, delivering both higher throughput and lower latency in one architecture without… pic.twitter.com/vj7VOrA8pP
— OpenAI (@OpenAI) August 25, 2026
ארכיטקטורה וטכנולוגיה
מבנה המעבד מותאם לטיפול בשני השלבים המרכזיים של הרצת מודלים: שלב עיבוד הפרומפט (Prefill), הדורש כוח חישוב אינטנסיבי, ושלב יצירת המענה (Decode), המוגבל ברוחב הפס של הזיכרון.
המערכת כוללת ארכיטקטורת רשת רחבה המאפשרת לעומס העבודה להישאר בתוך מתחם מקושר אחד, ללא עיכובים הנובעים ממעבר מידע בין רכיבים נפרדים.
לצורך תכנות ואופטימיזציה של החומרה, OpenAI עושה שימוש במודלי קוד כמו GPT-Astra ו-Codex. החברה מציינת כי יישומים שנוצרו על ידי AI עבור רכיבי קשב (Attention) ורכיבי מומחים מעורבים (Mixture of Experts) במודל GPT-OSS פעלו במהירות גבוהה פי 1.5 עד 1.8 לעומת קוד שנכתב בידי מפתחים.
ביצועים
בדיקות הביצועים של Jalapeño נערכו במבחן InferenceX מבית SemiAnalysis מול מערכות AI מסחריות קיימות, בהן מאיצי GB200 ו-GB300 של אנבידיה.
החברה פרסמה את ההשוואה מול מאיצי GB200 ו-GB300 של Nvidia, בבדיקות שנערכו מול מודלים ציבוריים בהם GPT-OSS 120B, DeepSeek R1 670B ו-Kimi K2.5 1T.
| מדד | Jalapeño לעומת המערכות המתחרות |
|---|---|
| מעטפת צריכת חשמל (TDP) | 700W, לעומת 1200W ב-GB200 ו-1400W ב-GB300 |
| צריכת חשמל רציפה בבדיקות | 550W ומטה |
| תפוקת שיא לכל וואט | גבוהה פי 1.5 עד 1.9 |
| זמן שיהוי מקצה לקצה | נמוך פי 1.7 עד 3.6 |
| ביצועים במשימות אינטראקטיביות | גבוהים פי 2.1 עד 4.1 |
| Kimi K2.5 1T | שיהוי נמוך פי 3.4, תפוקת שיא לוואט גבוהה פי 1.5 |
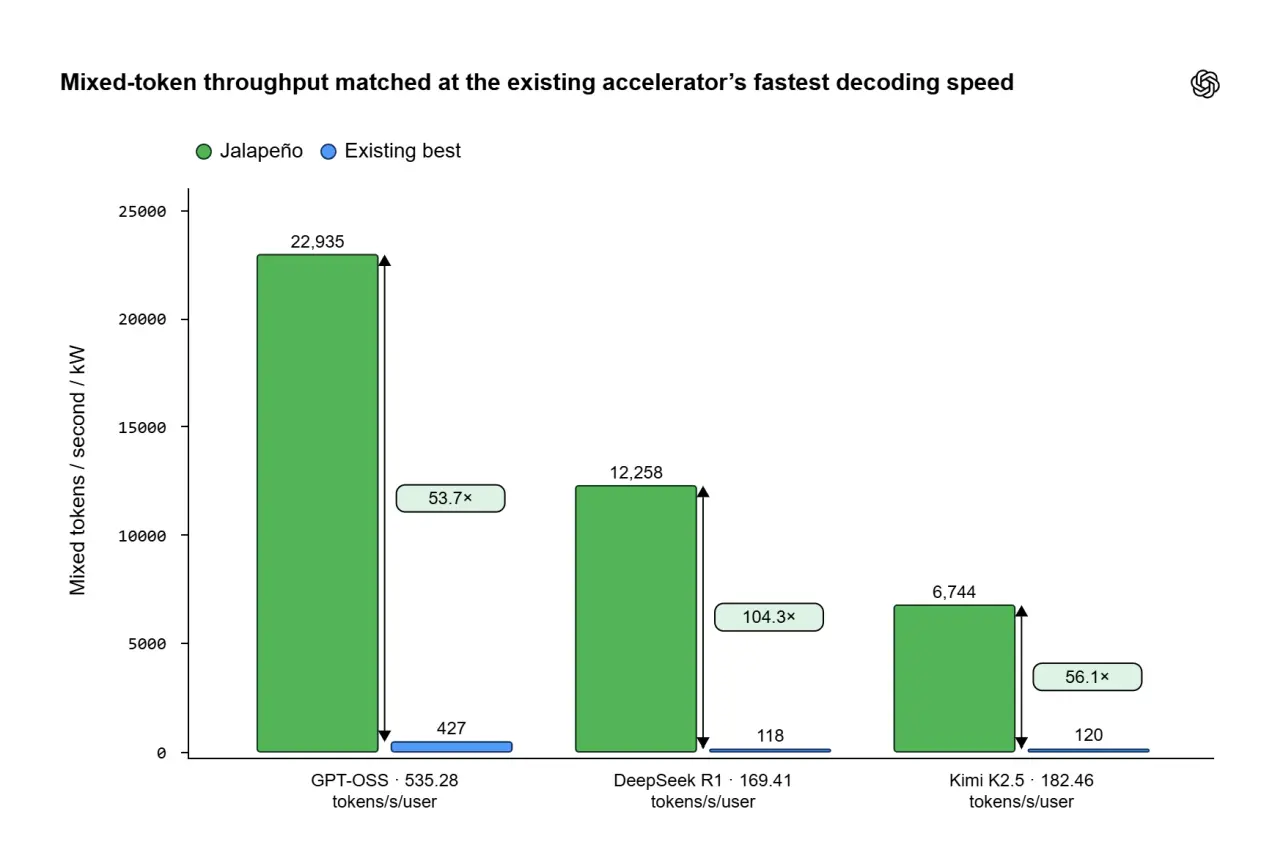
ביצועי מעבד Jalapeño (מקור OpenAI)
צריכת חשמל וקירור
פער צריכת החשמל הוא הבסיס ליתרון היעילות שהחברה מציגה. השבב פועל במעטפת נמוכה במידה ניכרת מזו של המערכות שנבדקו מולו, ובעומסי העבודה שנמדדו אף אינו מנצל אותה במלואה.
היעילות האנרגטית מאפשרת הפקת יותר טוקנים לכל קילו-וואט (Mixed tokens/s/kW), ומציבה את הפלטפורמה בעמדת יתרון בכל נקודות העבודה שנבדקו, החל ממצבי תפוקה גבוהה ועד למצבי שיהוי נמוך במיוחד.
לדברי OpenAI, המעבד יאפשר מתן שירותי הסקה מהירים וזולים יותר, וישפר את היכולת הכלכלית להפעיל מודלים מתקדמים בקנה מידה רחב.
לוחות זמנים
ההשקה המסחרית של מעבדי Jalapeño בתשתיות המחשוב של OpenAI צפויה להתחיל לקראת סוף שנת 2026.
במקביל, החברה ממשיכה לפתח את הדורות הבאים של הפלטפורמה, כאשר הדור השני נמצא בשלבי פיתוח מתקדמים והדור השלישי נמצא בתהליכי תכנון.

