

נקודות עיקריות
- •מיקרוסופט הציגה שלושה מודלי שמע ודיבור לפיתוח סוכנים קוליים אינטראקטיביים.
- •מודל התמלול MAI-Transcribe-2-Streaming מציג השערות ראשונות תוך מעט יותר מ-100 מילישניות.
- •מודלי הדיבור MAI-Voice-2.1 מאפשרים שמירה על זהות קולית אחידה במבטא מקומי ב-23 שפות.
- •המודלים זמינים כעת למפתחים במחיר של החל מ-0.54 דולר לשעת שמע ו-15 דולר למיליון תווים.
מיקרוסופט (Microsoft) מרחיבה את היצע מודלי ה-AI בתחום השמע עם שלושה מודלים חדשים: מודל תמלול בזמן אמת בשם MAI-Transcribe-2-Streaming, ושני מודלי הפקת דיבור מטקסט – MAI-Voice-2.1 וגרסת MAI-Voice-2.1-Flash המהירה.
המודלים משלבים הבנת שמע מדויקת לצד יצירת קול טבעי בעלות נמוכה, ונועדו לשמש רכיבי בסיס לבניית סוכני שיחה קוליים בעלי זמני תגובה קצרים במיוחד.
הכלים החדשים מיועדים לאפשר מענה שוטף בממשקי שיחה, שבהם נדרשת מערכת ה-AI לקלוט שמע, להבין את הנאמר, לבצע פעולות ולהגיב בקול בתוך חלון זמנים המדמה שיחה אנושית טבעית.
תמלול בזמן אמת עם MAI-Transcribe-2-Streaming
המודל MAI-Transcribe-2-Streaming מיועד לתמלול שמע חי בשיהוי נמוך ותומך ב-60 שפות לצד זיהוי שפה רציף ואוטומטי.
עברית נכללת ברשימת 60 השפות של MAI-Transcribe-2, לאחר שלא נתמכה בגרסה 1.5 הקודמת. מיקרוסופט טרם פרסמה רשימת שפות נפרדת לגרסת הזרימה, אך החברה מציינת כי גם היא תומכת ב-60 שפות.
בשונה ממודל MAI-Transcribe-2 הקודם, שעיבד קובצי שמע מוקלטים בלבד, המודל החדש פועל ישירות מול רצף שמע חי.
במקום להמתין לסיום הדיבור, המודל מפיק השערות תמלול ראשוניות (Partials) בתוך מעט יותר מ-100 מילישניות מרגע קבלת השמע.
הוא מעדכן את הטקסט באופן שוטף ככל שנוסף הקשר, ומקבע את התמלול הסופי באופן מיידי. מנגנון זה מאפשר לסוכני שיחה להתחיל בעיבוד הנתונים או בהפעלת כלים עוד לפני שהדובר סיים את המשפט.
Introducing 3 new models: MAI-Transcribe-2-Streaming, MAI-Voice-2.1 and MAI-Voice-2.1-Flash.
Accurate streaming transcription. Natural speech and less waiting between turns.
Build voice agents that keep the conversation moving! pic.twitter.com/QB6Yr9UiyK
— Microsoft AI (@MicrosoftAI) October 1, 2026
ביצועים ודיוק תמלול
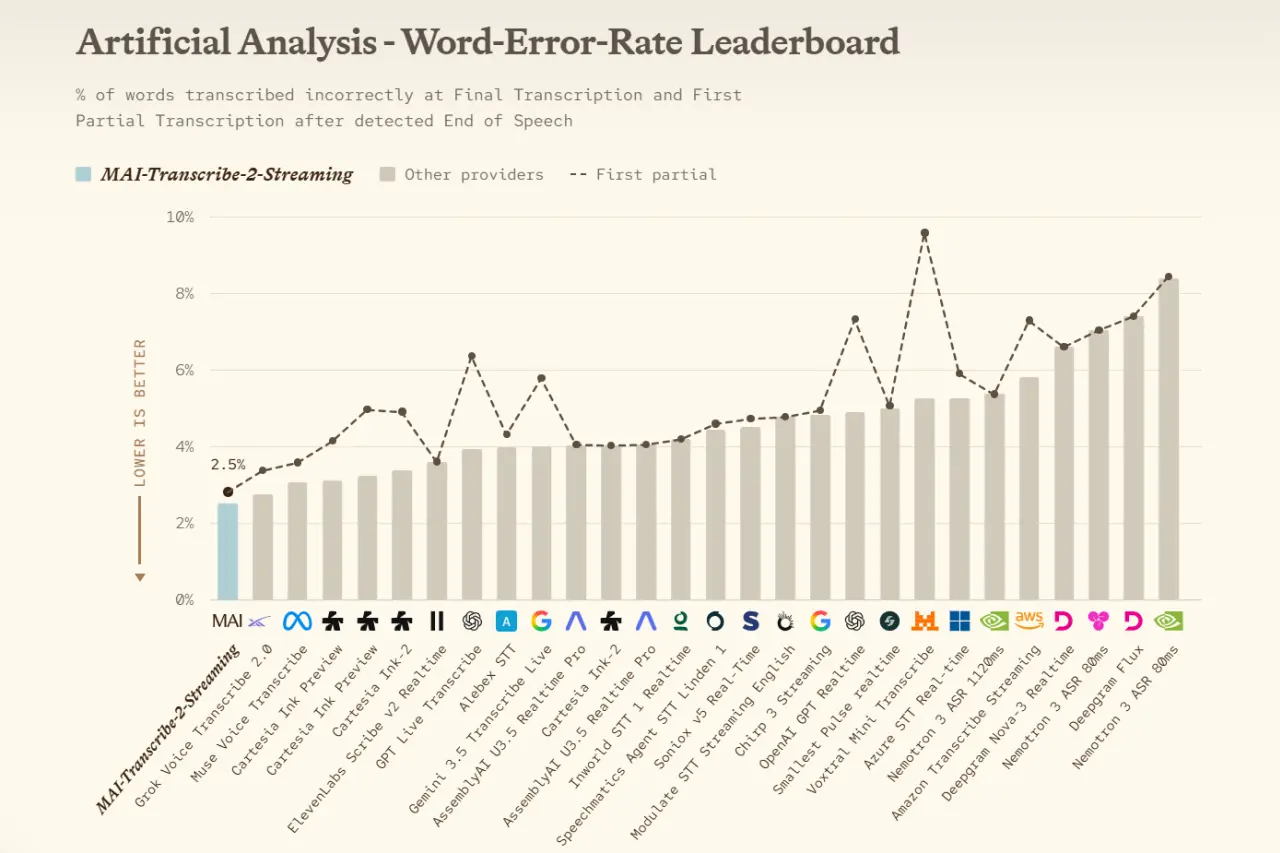
לדברי מיקרוסופט, המודל מדורג במקום הראשון בדיוק תמלול חלקי וסופי במדד של פלטפורמת Artificial Analysis.
החברה מציינת כי במבחני היחס בין דיוק לשיהוי המודל ניצב בחזית הביצועים, ללא פגיעה בדיוק לצורך השגת מהירות.
בבדיקות פנימיות שערכה החברה בתרחישי הכתבה והפקת כתוביות בזמן אמת, מילים הופיעו בתמליל במהירות כפולה בהשוואה למתחרה הקרוב ביותר.
בחודש הקודם הציגה החברה גם את מודל MAI-Transcribe-2 הלא מקוון, שלדבריה הציג ביצועים עדיפים על מודלים מתחרים מבית OpenAI וגוגל .
הפקת דיבור רב-לשונית עם MAI-Voice-2.1
לצד מודל התמלול, הכריזה מיקרוסופט על MAI-Voice-2.1 להפקת דיבור מטקסט (Text-to-Speech), התומך ב-23 שפות ב-26 ניבים מקומיים.
המודל מאפשר שימוש בקול יחיד המסוגל לעבור בין שפות שונות תוך שמירה על זהות הדובר ואימוץ מבטא מקומי טבעי, ללא גרירת מבטא זר משפה לשפה.
עברית אינה נכללת בשלב זה בין השפות הנתמכות במודלי הדיבור, וכך גם ערבית ויפנית. בין השפות הנתמכות נמצאות אנגלית, ספרדית, צרפתית, גרמנית, רוסית, סינית, קוריאנית והינדי.
שני מודלי הדיבור כוללים יכולת שיבוט קול (Voice Cloning) בכל השפות הנתמכות באמצעות דגימת שמע של שניות בודדות בלבד, לצד מנגנוני אבטחה והסכמה מובנים שנועדו למנוע שימוש לרעה.
גרסת MAI-Voice-2.1-Flash מבוססת על אותן יכולות שפה וזהות קולית, אך עברה התאמה לעומסי עבודה כבדים הדורשים שיהוי מינימלי.
המודל מסוגל לייצר 45 שניות של שמע בשיהוי כולל מקצה לקצה של כ-150 מילישניות, ולדברי החברה הוא מציג עיבוד מהיר ב-55% ומחיר נמוך בכ-60% ממודלים מקבילים.
זמינות ומחירים
שלושת המודלים זמינים כעת דרך Microsoft Foundry, פלטפורמת MAI Playground ו-Vercel. כמו כן, מיקרוסופט השיקה הדגמה אינטראקטיבית בשם Chatter ב-MAI Playground להמחשת פעולת המודלים יחד.
MAI-Transcribe-2-Streaming מוצע במחיר השקה של 0.54 דולר לשעת שמע עד סוף שנת 2026, לעומת מחיר של 0.10 דולר לשעה עבור מודל התמלול הלא מקוון.
מודל MAI-Voice-2.1 מתומחר ב-22 דולר למיליון תווים, בעוד גרסת MAI-Voice-2.1-Flash מתומחרת ב-15 דולר למיליון תווים.

