


⭐ נקודות עיקריות
- חברת Z.ai השיקה את מודל GLM-5.3 המיועד למשימות תכנות ארוכות טווח וסוכני AI אוטונומיים.
- המודל מבוסס על שלבי אימון מתקדם בלבד ומציג קפיצה בביצועי סייבר וגילוי חולשות אבטחה.
- במבחני תכנות מציג המודל שיפור ביצועים תוך חיסכון בצריכת טוקנים מול מודלים מובילים בתעשייה.
- הגישה למודל זמינה כעת למנויי החברה, כאשר משקלי הקוד הפתוח ישוחררו בהמשך ברישיון חופשי.
חברת Z.ai (לשעבר Zhipu AI) הכריזה על השקת GLM-5.3, מודל AI חדש המתמקד בפיתוח תוכנה אוטונומי ובמשימות סייבר מתקדמות.
המודל מתבסס על ארכיטקטורת הבסיס של קודמו בהיקף של כ-743 מיליארד פרמטרים, ומציג את המשך המעבר של החברה לעבר סוכני AI המסוגלים להתמודד עם רצפי עבודה הנדסיים מלאים הנמשכים מספר ימי עבודה של מהנדס אנושי.
GLM-5.3 הוא מודל שפה המיועד לביצוע משימות פיתוח ממושכות ומציג שיפור ניכר ביכולות גילוי חולשות אבטחה וניתוח שרשראות ניצול.
המודל מדגים כיצד הרחבת שלבי האימון המאוחרים (post-training) בלבד מאפשרת להפיק ביצועים משופרים ממודל קיים ללא צורך בסבב אימון מוקדם (pre-training) מלא ויקר.
מאפיינים עיקריים
GLM-5.3 מתבסס על מודל הבסיס הקיים של GLM-5.2, כאשר השיפורים כולם נובעים מהרחבת תהליכי הלמידה מחיזוקים (Reinforcement Learning) באמצעות תשתית הקוד הפתוח slime של החברה.
סביבות האימון נבנו כדי לדמות תרחישי פיתוח מלאים בעולם האמיתי, כולל גישה לקוד, מסדי נתונים, תיעוד, אשכולות מחשוב והרצת ניסויים לצורך איתור צווארי בקבוק.
שינוי משמעותי מגיע גם במבנה ה-API של המודל, אשר אינו מאפשר עוד ביטול של מנגנון החשיבה (Thinking). מפתחים נדרשים לבחור בין שלוש רמות מאמץ חשיבה (low, high ו-max), כאשר רמת max מוגדרת כברירת מחדל ומומלצת למשימות כתיבת קוד.
GLM-5.3 API is now live.
– Built for coding, defensive cybersecurity, and long-horizon agentic tasks
– Priced the same as GLM-5.2
– Available via the official API and partner model gatewaysGet started: https://t.co/3Dpy1tOdaM pic.twitter.com/yBzgPwTFxL
— Z.ai (@Zai_org) August 18, 2026
ביצועים
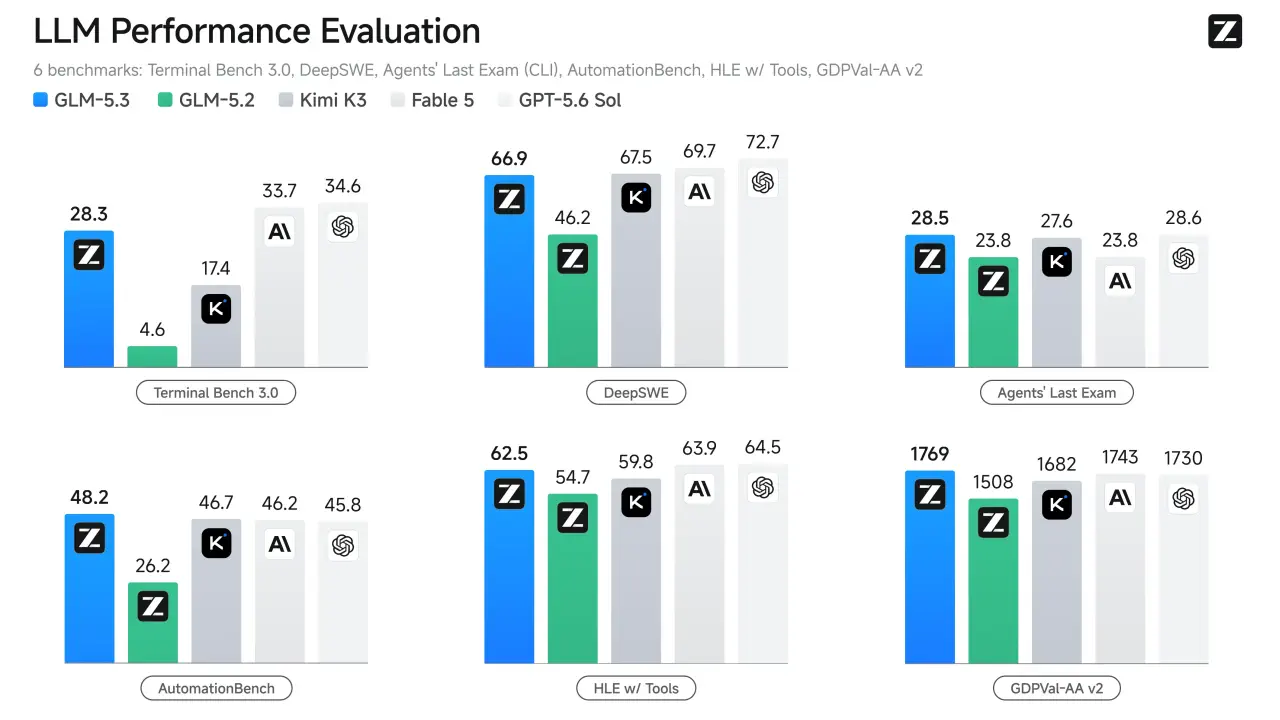
במבחני ביצועים של פיתוח תוכנה, GLM-5.3 מציג שיפור חד מול קודמו ומצמצם פערים מול מודלים מובילים:
- במבחן Terminal-Bench 3.0 עלה הציון מ-4.6 ל-28.3 נקודות לעומת 34.6 נקודות של GPT-5.6 Sol ו-33.7 נקודות של Claude Fable 5.
- במבחן DeepSWE v1.1 נרשם ציון של 66.9% לעומת 46.2% בגרסה הקודמת ו-72.7% של GPT-5.6 Sol.
- במבחן Agents' Last Exam עלה הציון ל-28.5 נקודות לעומת 23.8 נקודות ב-GLM-5.2, גבוהה יותר מה-23.8 נקודות של Claude Fable 5, אך נמוך ב-0.1 נקודות מ-GPT-5.6 Sol.
במבחן הפנימי Z.ai Code Bench הציג המודל שיפור של 50% בביצועי סוכני קוד תוך צריכת פחות טוקנים בפלט. ברמת המאמץ המרבית השיג המודל דיוק של 34.5% עם צריכה של כ-75,000 טוקנים למשימה לעומת 23.4% עם כ-96,000 טוקנים ב-GLM-5.2.
יכולות נוספות
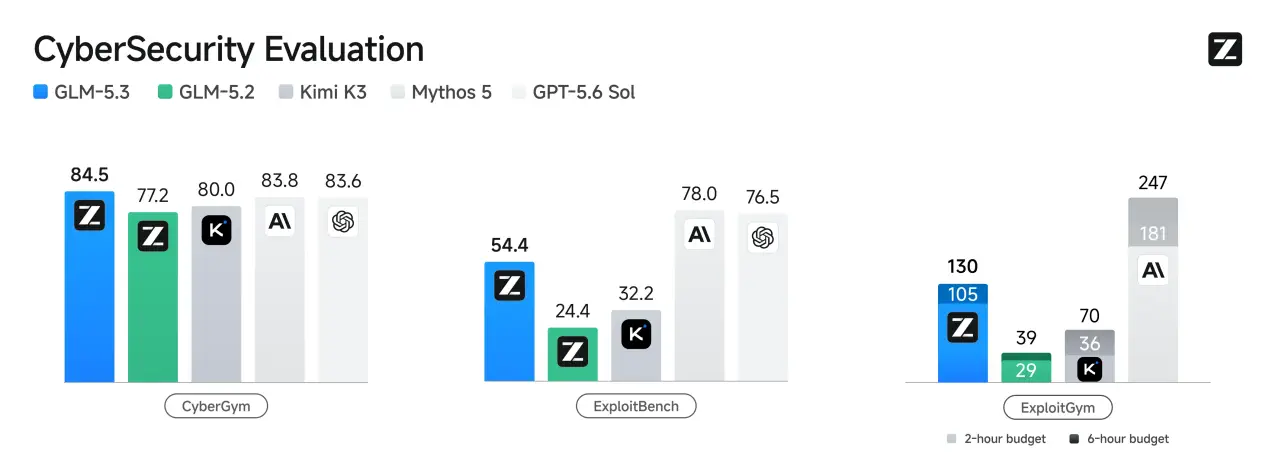
תחום הסייבר רשם התפתחות רחבה במסגרת האימון המאוחר, עם התקדמות באיתור חולשות ובניית שרשראות ניצול (exploitation chains). במבחן CyberGym השיג המודל ציון של 84.5% ועקף מודלים מתחרים דוגמת Mythos 5 שקיבל 83.8% ו-GPT-5.6 Sol עם 83.6%.
במבחן ExploitBench הגיע המודל ל-54.4% לעומת 24.4% ב-GLM-5.2, אך נותר מאחורי 78.0% של Mythos 5 ו-76.5% של GPT-5.6 Sol.
בבדיקות מול פרויקטים בעולם האמיתי בשיתוף צוותי אבטחה, זיהה המודל 2,436 חולשות אבטחה ב-269 פרויקטי קוד פתוח, כאשר 1,097 מהן סווגו בדרגת חומרה גבוהה או קריטית.
מחירים וזמינות
GLM-5.3 זמין כעת למשתמשי תוכנית המנויים GLM Coding Plan ובסביבת הפיתוח ZCode של החברה.
הגישה דרך ממשק ה-API מתומחרת ב-1.40 דולר למיליון טוקני קלט וב-4.40 דולר למיליון טוקני פלט, לצד תעריף מופחת של 0.26 דולר למיליון טוקנים בקריאה מזיכרון המטמון.
חלון ההקשר של המודל עומד על מיליון טוקנים, המאפשר לו להחזיק בסיסי קוד שלמים בזיכרון העבודה שלו במהלך משימה ממושכת.
החברה מסרה כי משקלי המודל (Open Weights) ישוחררו לציבור ברישיון פתוח בעוד כשבועיים, לאחר השלמת בדיקות בטיחות והקשחת המערכת.

