

נקודות עיקריות
- •חברת Reflection הציגה את Beam, מודל משקולות פתוחות הכולל 501 מיליארד פרמטרים.
- •המודל מתבסס על ארכיטקטורת MoE המפעילה 23 מיליארד פרמטרים בלבד בכל שלב של עיבוד.
- •לדברי המפתחים, Beam מספק יעילות היסק גבוהה פי 3 עד 4 בהשוואה למודלים מתחרים מקבילים.
- •המשקולות יופצו בהמשך החודש ברישיון Apache 2.0 לצד אפשרות גישה מוקדמת דרך רשימת המתנה.
חברת Reflection AI האמריקאית, שהוקמה על ידי חוקרים לשעבר ב-Google DeepMind, הכריזה על Beam, מודל בינה מלאכותית ראשון מתוצרתה במשקולות פתוחות (Open-Weight), שנבנה במטרה להתחרות ישירות במודלים פתוחים מתקדמים ומיועד בעיקר למשימות תכנות, פתרון בעיות מורכבות והפעלת סוכני בינה מלאכותית (Agents).
ארכיטקטורת המודל מתבססת על תצורת מומחים מעורבים (Mixture of Experts או MoE), המאגדת 501 מיליארד פרמטרים בסך הכל. מתוכם, רק 23 מיליארד פרמטרים מופעלים בפועל עבור כל טוקן, גישה המאפשרת לחסוך במשאבי חישוב תוך שמירה על ביצועים גבוהים.
לדברי החברה, השילוב בין אימון מקדים רחב היקף ללמידת חיזוק אינטנסיבית מאפשר למודל להציע יעילות היסק גבוהה פי 3 עד 4 מול מודלים פתוחים מובילים, בהם GLM 5.2 של Z.ai הסינית.
ההכרזה מגיעה בתקופה שבה זירת המודלים הפתוחים המתקדמים נשלטת בעיקר בידי חברות סיניות, בהן Zhipu AI (מוכרת כ-Z.ai) עם סדרת GLM שלה, Alibaba עם Qwen ו-DeepSeek.
Beam מציב את Reflection כאחת החברות האמריקאיות הבודדות שמנסות להציע חלופה פתוחה ברמה דומה, בזמן שרוב המעבדות האמריקאיות הגדולות שומרות את המודלים המתקדמים שלהן סגורים.
מאפיינים עיקריים
כדי לשמור על יציבות החישובים לאורך עשרות שכבות הרשת, Beam משלב טכניקות ייעודיות, בהן נרמול שכבות כפול (SandwichNorm) בכניסה וביציאה מכל תת-שכבה, מנגנון ויסות תשומת לב (Attention gating), וצבירת שאריות ברמת דיוק מלאה של 32 סיביות (FP32).
בנוסף, המודל משתמש במנגנון ניתוב מומחים אחיד, שבו המומחה העמוס ביותר פעיל רק פי 1.04 מהממוצע, לצד חלוקת עומסים ברמת הרצף.
המפתחים שילבו גם ענישה על אורך הפלט בשלבי למידת החיזוק, המעודדת הגעה לפתרון מדויק במינימום פעולות הסקה מיותרות, לצד אפשרות למשתמשים לקבוע את רמת מאמץ ההסקה הרצויה למשימה.
- ארכיטקטורה: MoE (Mixture of Experts)
- פרמטרים: 501 מיליארד
- פרמטרים פעילים: 23 מיליארד לכל טוקן
- חלון הקשר: 256K טוקנים במהלך למידת החיזוק, עם הרחבה עד מיליון טוקנים
- רישיון: Apache 2.0
Introducing Beam: a highly efficient agentic open model with 501B total parameters and 23B active.
– Frontier reasoning efficiency
– Advances the Western open frontier on coding & agentic tasks
– Trained end-to-end from scratchFull weights release this month.
Learn more about… pic.twitter.com/1rMABCywUG
— Reflection (@reflection_ai) October 5, 2026
ביצועים
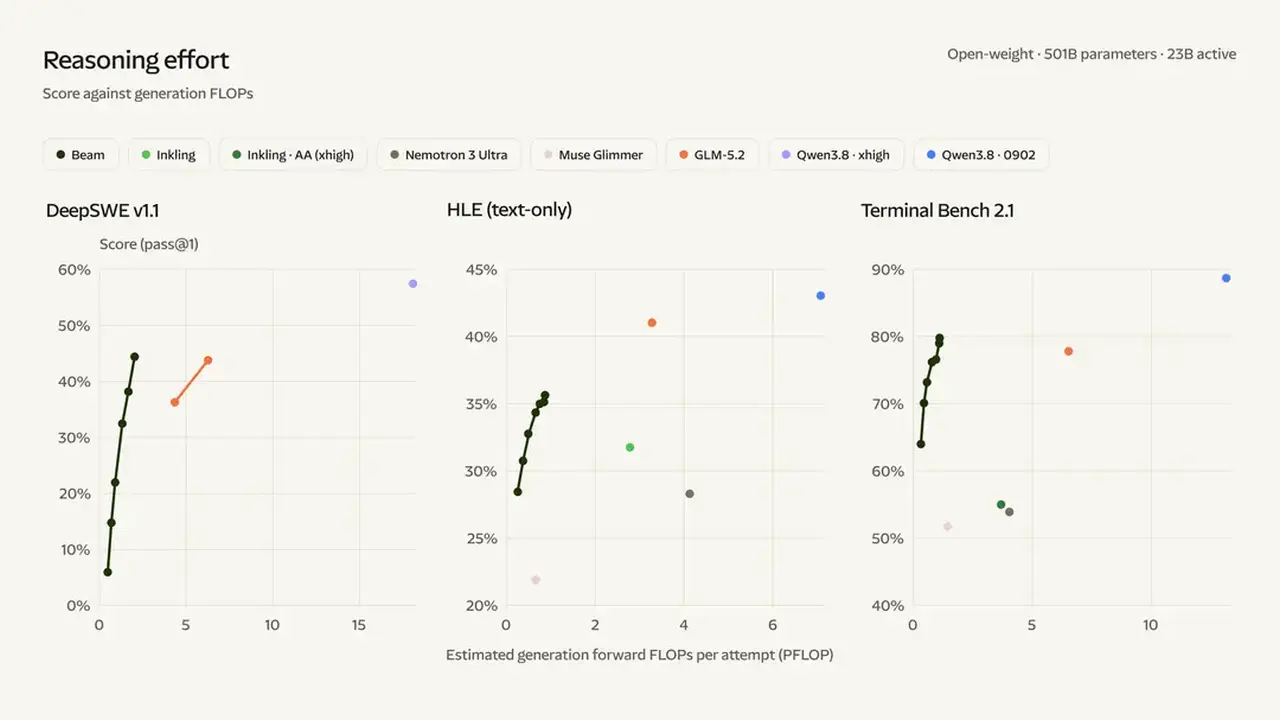
במבחני ביצועים המתמקדים בתכנות וסוכנים, Beam מתחרה ישירות מול שתי גרסאות מודל GLM הסיני: במבחן SWE Bench Pro v2-Hard רשם המודל ציון של 77.2%, מתחת ל-84.3% של GLM 5.3.
במבחן SWEBench Verified השיג Beam ציון של 80.9%, תוצאה הגבוהה מזו של Inkling ו-Nemotron 3 Ultra.
במבחן Terminal Bench v2.1 הגיע המודל ל-80.1%, לעומת 81.0% ב-GLM 5.2 ו-88.2% ב-GLM 5.3. במבחן DeepSWE v1.1 השיג Beam ציון של 44.4%, בהשוואה ל-44.0% ב-GLM 5.2 ו-61.0% ב-GLM 5.3.
לצד הציונים, Reflection מדגישה כי יתרונו המרכזי של Beam הוא ביעילות החישוב, שכן הוא דורש היקף FLOPs וטוקנים נמוך פי 3 עד 4 לעומת GLM 5.2 בהסקה מתקדמת.
יכולות נוספות
מעבר למשימות תכנות ישירות, למידת החיזוק סייעה למודל להפגין יכולות הכללה בתחומים שלא נכללו ישירות בתערובת האימון המקורית.
כאשר ניתנה לו גישה לרשת, המודל למד לבצע שאילתות עצמאיות מול מודלים אחרים ולהשתמש בממשקי OCR לקריאת מסמכים.
החברה הציגה הדגמות שבהן Beam בנה לוח מחוונים בזמן אמת עבור נתוני התחבורה של ניו יורק, יצר משחק תלת-ממדי באמצעות כתיבת קוד בספריית p5.js, וניסח מחברת עבודה (Notebook) לכוונון עדין (Fine-tuning) של מודל Gemma-4 למשימת Text2SQL.
זמינות
Beam מוצע בשלב זה בגישה מוקדמת מוגבלת דרך רשימת המתנה באתר החברה, בעודו עובר מבדקי הערכה ובטיחות סופיים.
במהלך אוקטובר 2026 מתכננת Reflection לשחרר את משקולות המודל באופן ציבורי תחת רישיון Apache 2.0.

